Huella digital infantil
A comienzos de octubre, una escuela de Lomas de Zamora se convirtió en noticia porque cincuenta alumnas fueron víctimas de imágenes manipuladas con inteligencia artificial que circularon por redes sociales y sitios pornográficos. En agosto, casos parecidos habían sacudido al Colegio Nacional de Buenos Aires y al Carlos Pellegrini.
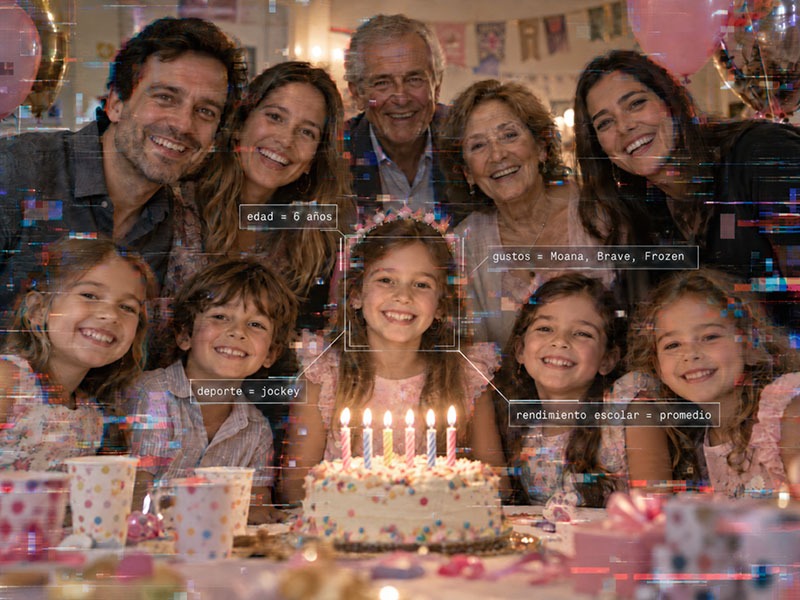
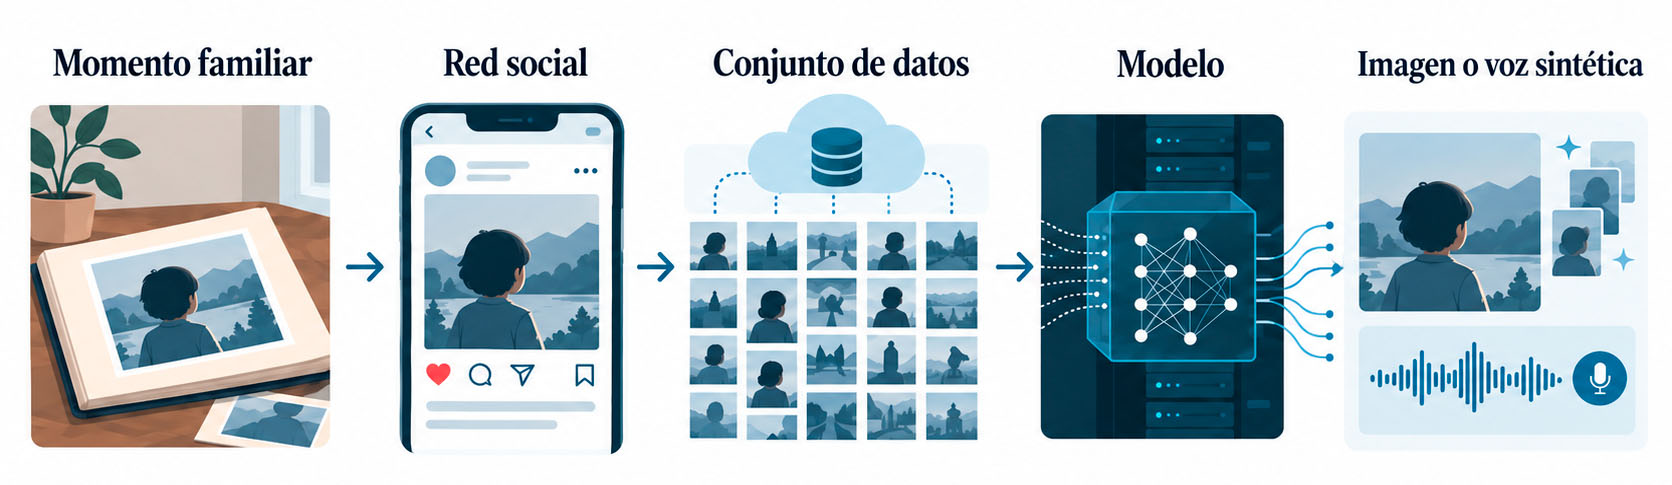
El punto de partida de cada uno de esos montajes fue una foto tomada inocentemente. Puede ser una imagen de un perfil, de un grupo de WhatsApp o de la publicación de padres orgullosos. Durante años tomamos esa foto como un bonito recuerdo, pero hoy la IA generativa puede convertirla en materia prima de algo más.
Este artículo forma parte de una publicación en espejo. Desde el OIA abordamos la huella digital infantil en clave tecnológica: qué le ocurre a una imagen cuando entra en la maquinaria de la IA. En paralelo, el Observatorio de Niñez, Adolescencia y Familia analiza el mismo fenómeno desde los derechos del niño.
Del álbum familiar al conjunto de entrenamiento
En 2024, la investigadora Hye Jung Han, de Human Rights Watch, revisó una pequeña muestra de LAION-5B. Se trata de uno de los conjuntos de datos más usados para entrenar generadores de imágenes; entre ellos, el más conocido es Stable Diffusion. LAION-5B no guarda las fotos en sí, sino que funciona como un enorme índice de conceptos. Contiene cerca de 5.850 millones de enlaces a imágenes de internet, cada uno con su descripción.
En una porción ínfima del total (menos del 0,0001 %), Han encontró 170 fotos identificables de niños brasileños y 190 de niños australianos. Algunas descripciones incluían nombres completos, edades y hasta el jardín de infantes al que asistían. Algunas se habían subido una década antes de que existiera el conjunto de datos.
Lo más inquietante no es la cantidad. Es que varias de esas familias habían tomado recaudos para que sus fotos no fueran fáciles de encontrar, pero no fue suficiente. Los programas que recorren la web para armar estos conjuntos (scrapers) no distinguen entre un álbum familiar y un catálogo de fotos de stock. Todo lo accesible es, en principio, recolectable.
Lo que la máquina no sabe olvidar
LAION retiró las fotos señaladas, lo que es un buen comienzo hacia una ética en el uso de la información. Ahora bien, quitar un enlace del índice no borra lo que un modelo ya aprendió durante su entrenamiento.
Entrenar un modelo se parece más a disolver tinta en agua que a guardar fotos en una carpeta. Cada imagen aporta un poco al resultado final y después ya no puede separarse con facilidad. Existen técnicas para que un modelo deconstruya algunos aprendizajes específicos, pero siguen siendo un campo de investigación abierto y no una solución disponible.
Además, los modelos a veces recuerdan más de lo que deberían. En 2023, Nicholas Carlini y su equipo demostraron que los generadores de imágenes por difusión memorizan ejemplos individuales de su entrenamiento. Lograron extraer más de mil imágenes originales, entre ellas fotografías de personas reales. La foto que alguien subió hace diez años puede, en ciertas condiciones, volver a aparecer.
Un clon en tres segundos
Hoy basta con una sola foto de un rostro para fabricar imágenes falsas convincentes (deepfakes). Y una muestra de audio de unos pocos segundos permite imitar una voz.
Entre fines de diciembre de 2025 y comienzos de enero de 2026, la herramienta de edición de imágenes de Grok, integrada en X, permitió «desvestir» fotos reales con una instrucción simple. El Centro para Contrarrestar el Odio Digital (CCDH) estimó unas 23.000 imágenes sexualizadas que parecían representar a menores en apenas once días. La Internet Watch Foundation identificó durante 2025 más de 8.000 imágenes y videos realistas de abuso sexual infantil generados con IA. Los videos pasaron de 13 a 3.443 en un solo año. Y el 97 % de las imágenes generadas mostraba a niñas.
El riesgo no es solo sexual. Investigadores de McAfee comprobaron que tres segundos de audio alcanzan para clonar una voz con un 85 % de coincidencia. Un video de un acto escolar puede alimentar la llamada falsa de un hijo «en apuros». Y el nombre, la fecha de nacimiento y la escuela que acompañan muchas publicaciones son justo los datos que se usan para suplantar identidades.
El medio sigue siendo el mensaje
Marshall McLuhan sostenía que los medios no son simples canales porque la naturaleza de una tecnología o de un canal de comunicación influye en la sociedad mucho más que la información concreta que transmite. La fotografía familiar no era una documentación oficial, sino un arcón de sentimientos. Con el tiempo, algo de eso permeó en la web con sitios como Facebook, pero empezó a dejar una sensación inquietante. Uno compartía el álbum familiar con las personas de confianza, pero las fotos en la web son vistas por conocidos y desconocidos por igual.
Con la IA generativa aparece un tercer público, invisible y no humano: los sistemas que la leen, la clasifican y aprenden de ella, esta vez sin sentimientos. El gesto de publicar sigue siendo el mismo. Lo que cambió es su significado. Antes, compartir era mostrar. Ahora, también es entrenar.
La investigadora Veronica Barassi describe a los niños de hoy como la primera generación datificada desde antes de nacer: aplicaciones de embarazo, ecografías publicadas, plataformas escolares. Esa huella la construyen otros, sin el consentimiento de quien la lleva. La IA la vuelve, a la vez, más valiosa y más maleable.
En 2023, la empresa Deutsche Telekom lo mostró con una campaña inquietante. Creó con IA una versión adulta de Ella, una niña de nueve años, que reprochaba a sus padres las fotos que habían publicado de ella. La paradoja era deliberada: la propia IA advertía sobre sus peligros.
Lo que la tecnología puede hacer depende de nosotros
La limpieza de LAION demuestra que es posible depurar un conjunto de datos cuando alguien lo audita. El dato inquietante es que pudo auditarse porque era abierto; los conjuntos privados de las grandes empresas siguen sin revisión externa. UNICEF reclama a los desarrolladores seguridad desde el diseño: filtros antes del entrenamiento, salvaguardas al generar y detección temprana en las plataformas.
Pero ningún filtro reemplaza una decisión previa. Algunas pautas concretas reducen la exposición:
- Publicar menos y con menos datos: sin nombres completos, uniformes, fechas ni ubicaciones.
- Revisar los metadatos de las fotos, que pueden incluir coordenadas GPS.
- Preferir grupos pequeños y cerrados, sabiendo que ninguna configuración de privacidad es una garantía.
- Acordar en familia una palabra clave para verificar llamadas de emergencia.
Quienes trabajamos en educación tenemos una tarea doble. Las instituciones también publican fotos de estudiantes, actos y aulas. Y la alfabetización digital ya no puede limitarse a «no hablar con desconocidos». Tiene que incluir cómo funciona la IA que transforma lo que subimos.
Una pregunta antes de publicar
La huella digital infantil no es nueva. Lo nuevo es lo que una máquina puede hacer con ella. Una foto ya no es solo un instante congelado: es un insumo que puede reaparecer en un conjunto de datos, en un modelo o en un montaje que nadie autorizó.
Durante años nos preguntamos quién iba a ver una foto. Hoy conviene preguntarse qué podría hacer una máquina con ella. Si siente una sensación incómoda, mejor deje esa imagen en el álbum impreso.
Para cerrar, le invitamos a leer la otra mitad de esta reflexión, en nota desarrollada por el Observatorio de Niñez, Adolescencia y Familia en su artículo espejo "La huella invisible: qué datos dejan niñas, niños y adolescentes cuando conversan con la inteligencia artificial(opens in new tab)"
Referencias citadas
- Ávila J. (2026). La huella invisible: qué datos dejan niñas, niños y adolescentes cuando conversan con la inteligencia artificial. Observatorio de Niñez, Adolescencia y Familia. Universidad del Aconcagua. https://onaf.uda.edu.ar/la-huella-invisible-que-datos-dejan-ninas-ninos-y-adolescentes-cuando-conversan-con-la-inteligencia-artificial/
- Barassi, V. (2020). Child Data Citizen: How Tech Companies Are Profiling Us from before Birth. MIT Press. https://doi.org/10.7551/mitpress/12415.001.0001
- Carlini, N., Hayes, J., Nasr, M., et al. (2023). Extracting Training Data from Diffusion Models. arXiv. https://doi.org/10.48550/arXiv.2301.13188
- Center for Countering Digital Hate (2026). Estimaciones sobre imágenes sexualizadas generadas por Grok (29/12/2025 – 08/01/2026). Reportado por Decrypt y Europa Press, 22-23 de enero de 2026.
- Chequeado (2026, 8 de octubre). Qué hacer si tu hija o hijo es víctima de un deepfake sexual creado con IA. https://chequeado.com/el-explicador/que-hacer-si-tu-hija-o-hijo-es-victima-de-un-deepfake-sexual-creado-con-ia/
- Human Rights Watch (2024, 10 de junio). Brasil: Fotos personales de niños utilizadas indebidamente para alimentar herramientas de IA. https://www.hrw.org/es/news/2024/06/10/brasil-fotos-personales-de-ninos-utilizadas-indebidamente-para-alimentar
- Human Rights Watch (2024, 6 de septiembre). Mejor protección para 720 niños y niñas de Brasil y Australia frente al uso indebido de la IA. https://www.hrw.org/es/news/2024/09/06/mejor-proteccion-para-720-ninos-y-ninas-de-brasil-y-australia-frente-al-uso
- Internet Watch Foundation (2026). Annual Data & Insights Report 2025. https://www.iwf.org.uk/annual-data-insights-report-2025
- McAfee (2023). The Artificial Imposter. https://www.businesswire.com/news/home/20230501005587/en
- UNICEF (2026, 4 de febrero). Los abusos cometidos mediante deepfake siguen siendo abusos. https://www.unicef.org/argentina/comunicados-prensa/los-abusos-cometidos-mediante-deepfake-siguen-siendo-abusos
- Deutsche Telekom (2023). Campaña #ShareWithCare – A Message from Ella. https://www.youtube.com/watch?v=F4WZ_k0vUDM&t=16s
Atribución
Artículo elaborado con asistencia de Claude (investigación y síntesis). Artículos científicos localizados y verificados con Scite. Datos de informes y casos verificados mediante búsqueda web en fuentes primarias (Human Rights Watch, Internet Watch Foundation, UNICEF) y medios especializados. Imágenes generadas con ChatGPT. La versión final fue revisada y redactada por el autor.